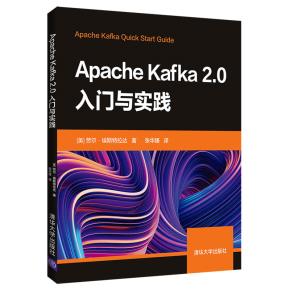
ApacheKafka2.0入门与实践"
本书详细阐述了与Apache Kafka 2.0相关的基本解决方案,主要包括配置Kafka、消息验证、消息增强、序列化、模式注册表、Kafka Streams、KSQL、Kafka Connect等内容。此外,本书还提供了相应的示例、代码,以帮助读者进一步理解相关方案的实现过程。
本书既可作为高等院校计算机及相关专业的教材和教学参考书,也可作为相关开发人员的自学教材和参考手册。
前 言
自2011年以来,Kafka突然呈爆炸式增长。超过三分之一的财富500强公司均采用了Apache Kafka。这些公司包括旅游公司、银行、保险公司和电信公司。
同时,Uber、Twitter、Netflix、Spotify、Blizzard、LinkedIn和PayPal等公司每天也采用Apache Kafka处理大量的消息。
时至今日,Apache Kafka可用于采集数据、执行实时数据分析,并执行实时数据流处理。另外,Kafka还可用于向复杂事件处理(CEP)架构中输入事件、部署于微服务架构中,并可实现于物联网架构中。
在数据流领域中,Kafka Streams也面临着一些竞争对手,例如Apache Spark、Apache Flink、Akka Streams、Apache Pulsar和Apache Beam。尽管如此,Apache Kafka仍拥有一个无法替代的优势,即易于使用。Kafka易于实现和维护,其学习曲线也相对平缓。
本书是一本实用的快速入门指南,并侧重于展示实际用例,且较少涉及Kafka架构方面的理论知识。本书旨在讲解Apache Kafka使用者所面临的日常问题。
适用读者
? 本书是一本适用于数据工程师、软件开发人员和数据架构师的快速入门指南。
? 本书注重于编程实现过程,同时详细介绍了Apache Kafka 2.0方面的知识。
? 书中的全部示例均采用Java 8实现,因此建议读者具有与Java 8相关的背景知识,这也是阅读本书的唯一前提条件。
本书内容
第1章:配置Kafka。介绍了Apache Kafka 2.0的基础知识,包括如何安装、配置和运行Kafka。此外,本章还讨论了如何利用Kafka代理和topic执行基本的操作。
第2章:消息验证。探讨了如何针对企业服务总线进行数据验证,其间还会涉及如何从输入流中过滤消息。
第3章:消息增强。将考查消息增强机制,对于企业服务总线来说,这也是一项较为重要的任务。消息增强可将附加信息整合至系统消息中。
第4章:序列化。将讨论如何构建序列化器和反序列化器,进而写入、读取或转换消息(二进制、原始字符串、JSON或Avro格式)。
第5章:模式注册表。将利用Kafka Schema Registry验证、序列化、反序列化并维护消息的历史版本。
第6章:Kafka Streams。将阐述如何获取与消息分组相关的信息(消息流),以及如何获取附加信息。例如,如何利用Kafka Streams处理消息的聚合和合成操作。
第7章:KSQL。将讨论如何在Kafka Streams的基础上利用SQL操控事件流。
第8章:Kafka Connect。将介绍快速数据处理工具,以及如何与Apache Kafka结合使用以生成数据处理管线。其中,相关工具包括Apache Spark和Apache Beam。
背景知识
在阅读本书时,建议读者具有Java 8方面的编程背景知识。
执行本书示例所需的最低配置是IntelRCore i3处理器、4GB RAM和128GB磁盘空间。这里推荐使用Linux或macOS操作系统,因为相关示例并不完全支持Windows操作系统。
资源下载
读者可访问http://www.packtpub.com并通过个人账户下载示例代码文件。另外,在http://www.packtpub.com/support中注册成功后,我们将以电子邮件的方式将相关文件发与读者。
读者可根据下列步骤下载代码文件:
? 利用电子邮件地址和密码登录或注册我们的网站www.packtpub.com。
? 单击SUPPORT选项卡。
? 单击Code Downloads & Errata。
? 在Serach文本框中输入书名。
当文件下载完毕后,确保使用下列最新版本软件解压文件夹:
? Windows系统下的WinRAR/7-Zip。
? Mac系统下的Zipeg/iZip/UnRarX。
? Linux系统下的7-Zip/PeaZip。
另外,读者还可访问 GitHub 获取本书的代码包,对应网址为 https://github.com/ PacktPublishing/Apache-Kafka-Quick-Start-Guide。
此外,读者还可访问 https://github.com/PacktPublishing/以了解丰富的代码和视频资源。
本书约定
本书通过不同的文本风格区分相应的信息类型。下面通过一些示例对此类风格以及具体含义的解释予以展示。
代码块如下所示。
{
"event": "CUSTOMER_CONSULTS_ETHPRICE",
"customer": {
"id": "14862768",
"name": "Snowden, Edward",
"ipAddress": "95.31.18.111"
},
"currency": {
"name": "ethereum",
"price": "RUB"
},
"timestamp": "2018-09-28T09:09:09Z"
}
当某个代码块希望引起读者的足够重视时,一般会采用黑体表示,如下所示。
dependencies {
compile group: 'org.apache.kafka', name: 'kafka_2.12',
version:'2.0.0'
compile group: 'com.maxmind.geoip', name: 'geoip-api',
version:'1.3.1'
compile group: 'com.fasterxml.jackson.core', name: 'jackson-core',
version: '2.9.7'
}
命令行输入或输出则采用下列方式表达:
> <confluent-path>/bin/kafka-topics.sh --list --ZooKeeper
localhost:2181
图标表示较为重要的说明事项。
图标则表示提示信息和操作技巧。
读者反馈和客户支持
欢迎读者对本书的建议或意见予以反馈。
对此,读者可向feedback@packtpub.com发送邮件,并以书名作为邮件标题。若读者对本书有任何疑问,均可发送邮件至questions@packtpub.com,我们将竭诚为您服务。
若读者针对某项技术具有专家级的见解,抑或计划撰写书籍或完善某部著作的出版工作,则可访问www.packtpub.com/authors。
勘误表
尽管我们在最大程度上做到尽善尽美,但错误依然在所难免。如果读者发现谬误之处,无论是文字错误抑或是代码错误,还望不吝赐教。对此,读者可访问http://www. packtpub.com/submit-errata选取对应书籍,单击Errata Submission Form超链接,并输入相关问题的详细内容。
版权须知
一直以来,互联网上的版权问题从未间断,Packt出版社对此类问题异常重视。若读者在互联网上发现本书任意形式的副本,请告知网络地址或网站名称,我们将对此予以处理。关于盗版问题,读者可发送邮件至copyright@packtpub.com。
问题解答
若读者对本书有任何疑问,均可发送邮件至questions@packtpub.com,我们将竭诚为您服务。

目 录
第1章 配置Kafka 1
1.1 Kafka简介 1
1.2 安装Kafka 2
1.2.1 在Linux中安装Kafka 4
1.2.2 在macOS中安装Kafka 5
1.2.3 安装Confluent Platform 7
1.3 运行Kafka 8
1.4 运行Confluent Platform 8
1.5 运行Kafka代理 10
1.6 运行Kafka topic 13
1.7 命令行消息生产者 16
1.8 命令行消息消费者 17
1.9 使用kafkacat 18
1.10 本章小结 19
第2章 消息验证 20
2.1 企业服务总线 20
2.2 事件建模 21
2.3 配置项目 23
2.4 从Kafka中读取数据 26
2.5 向Kafka中写入数据 29
2.6 运行处理引擎 31
2.7 验证器的Java编码 33
2.8 运行验证 35
2.9 本章小结 38
第3章 消息增强 39
3.1 获取地理位置 40
3.2 增强消息 42
3.3 析取货币价格 44
3.4 利用货币价格充实消息 46
3.5 运行引擎 48
3.6 析取天气数据 51
3.7 本章小结 52
第4章 序列化 53
4.1 Kafka物联网公司Kioto 53
4.2 项目配置 54
4.3 Constants类 56
4.4 HealthCheck消息 58
4.5 Java PlainProducer类 59
4.6 运行PlainProducer 62
4.7 Java PlainConsumer类 63
4.8 Java PlainProcessor对象 64
4.9 运行PlainProcessor 67
4.10 自定义序列化器 68
4.11 Java CustomProducer类 69
4.12 运行CustomProducer 70
4.13 自定义反序列化器 71
4.14 Java CustomConsumer类 72
4.15 Java CustomProcessor类 73
4.16 运行CustomProcessor 75
4.17 本章小结 76
第5章 模式注册表 77
5.1 Avro简介 77
5.2 定义模式 78
5.3 启动Schema Registry 79
5.4 使用Schema Registry 80
5.4.1 在值主题下注册一个新的模式版本 80
5.4.2 在键主题下注册一个新的模式版本 81
5.4.3 将现有的模式注册至新的主题中 82
5.4.4 列出全部主题 82
5.4.5 通过全局唯一ID查询模式 82
5.4.6 列出注册于healthchecks-value主题下的全部模式版本 83
5.4.7 查询注册于healthchecks-value主题下的模式版本1 83
5.4.8 删除注册于healthchecks-value主题下的模式版本1 83
5.4.9 删除最近注册于healthchecks-value主题下的模式 83
5.4.10 删除注册于healthchecks-value主题下的全部模式版本 84
5.4.11 检测模式是否已注册于healthchecks-key主题下 84
5.4.12 模式兼容性测试 84
5.4.13 获取顶级兼容性配置 84
5.4.14 全局更新兼容性需求条件 85
5.4.15 更新healthchecks-value主题下的兼容性需求条件 85
5.5 Java AvroProducer 85
5.6 运行AvroProducer 89
5.7 Java AvroConsumer类 91
5.8 Java AvroProcessor类 92
5.9 运行AvroProcessor 94
5.10 本章小结 95
第6章 Kafka Streams 96
6.1 Kafka Streams简介 96
6.2 项目配置 97
6.3 Java PlainStreamsProcessor类 98
6.4 运行PlainStreamsProcessor 101
6.5 Kafka Streams扩展 102
6.6 Java CustomStreamsProcessor类 103
6.7 运行CustomStreamsProcessor 104
6.8 Java AvroStreamsProcessor类 105
6.9 运行AvroStreamsProcessor 107
6.10 延迟事件处理 108
6.11 基本场景 109
6.12 延迟事件的生成 110
6.13 运行EventProducer 112
6.14 Kafka Streams处理程序 113
6.15 运行流处理程序 115
6.16 流处理程序分析 116
6.17 本章小结 117
第7章 KSQL 118
7.1 KSQL简介 118
7.2 运行KSQL 119
7.3 使用KSQL CLI 120
7.4 利用KSQL处理数据 122
7.5 写入topic中 123
7.6 本章小结 126
第8章 Kafka Connect 127
8.1 Kafka Connect简介 127
8.2 项目配置 128
8.3 Spark流处理程序 129
8.4 从Spark中读取Kafka 130
8.5 数据转换 131
8.6 数据处理 133
8.7 从Spark中写入至Kafka 133
8.8 运行SparkProcessor 135
8.9 本章小结 136
本书是一本适用于数据工程师、软件开发人员和数据架构师的快速入门指南,详细阐述了与Apache Kafka 2.0相关的基本解决方案,主要包括配置Kafka、消息验证、消息增强、序列化、模式注册表、Kafka Streams、KSQL、Kafka Connect等内容。本书注重于编程实现过程,并提供了相应的示例、代码,以帮助读者进一步理解相关方案的实现过程。
本书是一本适用于数据工程师、软件开发人员和数据架构师的快速入门指南,详细阐述了与Apache Kafka 2.0相关的基本解决方案,主要包括配置Kafka、消息验证、消息增强、序列化、模式注册表、Kafka Streams、KSQL、Kafka Connect等内容。本书注重于编程实现过程,并提供了相应的示例、代码,以帮助读者进一步理解相关方案的实现过程。
