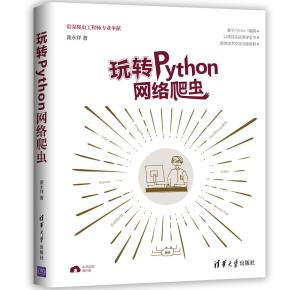
玩转Python网络爬虫"
作者:黄永祥
ISBN:9787302503286
定价:¥69
字数:千字
页数:
出版时间:2018.08.01
开本:
版次:1-2
装帧:
出版社:清华大学出版社
简介
本书站在初学者的角度,从原理到实践,循序渐进地讲述了使用Python开发网络爬虫的核心技术。全书从逻辑上可分为基础篇、实战篇和爬虫框架篇三部分。基础篇主要介绍了编写网络爬虫所需的基础知识,分别是网站分析、数据抓取、数据清洗和数据入库。网站分析讲述如何使用Chrome和Fiddler抓包工具对网络做全面分析;数据抓取介绍了Python爬虫模块Urllib和Requests的基础知识;数据清洗主要介绍字符串操作、正则和Beautiful Soup的使用;数据入库分别讲述了MySQL和MongoDB的操作,通过ORM框架SQLAlchemy实现数据持久化,实现企业级开发。实战篇深入讲解了分布式爬虫、爬虫软件开发与应用、12306抢票程序和微博爬取,所举示例均来自于开发实践,可帮助读者快速提升技能,开发实际项目。框架篇主要讲述Scrapy的基础知识,并通过爬取QQ音乐为实例,让读者深层次了解Scrapy的使用。
本书内容丰富,注重实战,适用于从零开始学习网络爬虫的初学者,或者是已经有一些网络爬虫编写经验,但希望更加全面、深入理解Python爬虫的开发人员。
前言

目录
作者简介
编辑推荐
本书站在初学者的角度,从原理到实践,深入、系统地阐述了使用Python 3开发网络爬虫的核心技术,全书从逻辑上可分为基础篇、实战篇和爬虫框架篇三部分。
