本科|本科|信息技术|大数据与云计算
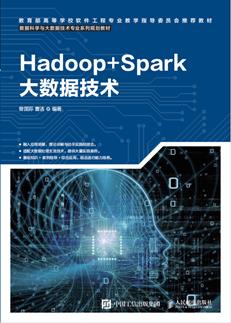
Hadoop+Spark大数据技术"
作者:曾国荪曹洁
ISBN:978-7-115-58327-7
定价:¥59.80
字数:千字
页数:261
出版时间:2022-09-01
开本:16开
版次:
装帧:
出版社:人民邮电出版社
简介
本书主要讲解Hadoop的分布式文件系统、MapReduce编程模型和Spark大数据处理技术。全书共12章,具体包括大数据概述、Hadoop大数据处理架构、HDFS分布式文件系统、MapReduce分布式计算框架、HBase分布式数据库、Spark概述、基于Scala的Spark编程、Windows环境下Spark综合编程、Spark SQL结构化数据处理、Spark Streaming流计算、Spark GraphX图计算、项目实训:《平凡的世界》孙家人物关系图分析。 本书可作为高等院校计算机、信息管理、软件工程、大数据、人工智能等相关专业的大数据课程教材,也可供企业中从事大数据开发的工程师和科技工作者参考。
前言

目录
作者简介
曾国荪,同济大学电子与信息工程学院计算机科学与技术系,教授,博导。长期从事并行分布处理、可信网络软件设计与验证、云计算和大数据等领域的理论和应用研究工作。先后主持负责1项973课题、3项863课题、7项国家基金项目。在IEEE Transactions,中国科学、计算机学报、软件学报等国内外核心刊物上发表学术论文250余篇。出版著作3本。
曹洁,博士,毕业于同济大学计算机软件与理论专业,郑州轻工业大学软件学院教师,硕导。研究方向:并行分布式处理、云计算等。在软件学报、电子学报、计算机研究与发展、通信学报等核心刊物上发表学术论文10余篇。主讲:大数据技术、大数据分析等课程。主编出版11部教材。
编辑推荐
作者寄语
电子资料
